- 作者:本站
- 发表时间:2026-11-09 浏览次数:15
手机群控系统风控规避这件事,核心结论先放前面:可持续的做法不是研究怎么绕过平台检测,而是把设备、网络、行为、账号、数据、运维和审计做成可解释、可追溯、可限权、能降级的合规闭环,先降低误判率,再控制连带风险。
任何以对抗规则为目的的“技巧”都短命,真正能落地的是把手机群控系统当成一套受控的生产工具来管理,下面按七个层面拆开说,每个层面先给判断,再讲实操细节。
一、先划清“规避”的边界:合规是手机群控系统风控管理的前提
这一层的关键不是找漏洞,而是把“规避”限定为降低误判、减少连带和保证可恢复,越界对抗平台规则,短期可能有效,长期一定不可持续。
不少团队一上来就问改机、代理、拟人脚本,我不建议把精力花在这上面,原因很现实:平台风控是动态的,对抗成本会越来越高;一旦某个设备或出口被标记,连带损失往往比省下的时间更大;更重要的是,账号来源、使用场景和授权边界如果说不清,后面所有技术动作都站不住。
实操上先写清楚使用场景、账号来源、数据范围和任务白名单,把“不能做”写进流程,风控规避不是技术隐藏,而是管理上能解释。
二、设备层先做“一机一档”:别让硬件指纹成为触发点
设备层该先做的不是改参数,而是建立一机一档,让每台设备的硬件状态、系统版本、维修记录和上线轨迹都能解释,硬件指纹高度雷同、频繁刷机改机,比“不够像真人”更容易触发误判。
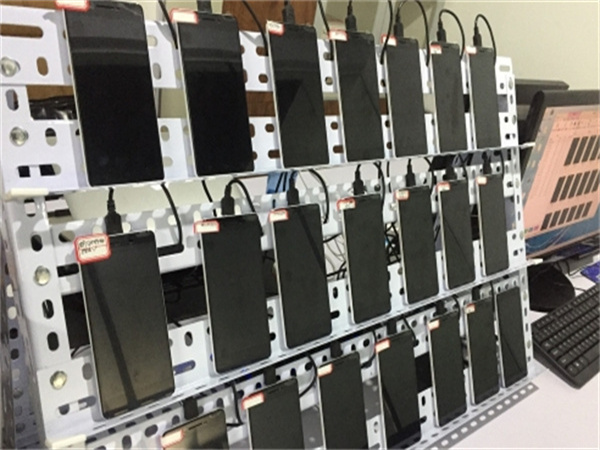
我在实际运维里更愿意先看三张表:设备台账、出口台账、任务台账,设备台账至少记录设备编号、型号、系统版本、传感器状态、电池健康、网络绑定、采购批次、维修记录和责任人。
同批次设备不要集中上线,异常设备先隔离,别让一台问题机反复重试,来源不明的改装机、来路不清的二手设备,能不用就不用,设备轮换要有节奏,今天上线一批、明天全换,这种动作本身就不自然。
三、网络出口要“可解释”:IP、时段、地域别互相打架
网络层的答案很直接:出口要稳定、归属要清楚、设备和出口的对应关系要能讲明白,频繁跳IP、出口地域和业务场景对不上、共享出口并发过高,都是典型误判源。
建议单独建出口台账,记录IP段、归属地、绑定设备组、并发上限、使用时段和责任人,一个设备组尽量绑定相对稳定的出口,不要一到高峰就切来切去;共享出口要设并发上限,别把一堆设备塞进同一条线;来路不明的代理资源不要碰,出口异常要能告警,比如归属地突变、延迟飙升、认证失败率上升,这些信号比“再换一个IP”更有价值。
四、行为节律别追求“像真人”,先追求“不异常”
行为层不要迷信“拟人脚本”,先做到节律稳定、失败可控、放量有灰度,端高频、机械重复、失败后疯狂重试,比不够拟真更容易被识别。
实操上先定业务合理性:任务量要和账号权限匹配,任务间隔要有分布,失败重试要设上限,成功率和失败率要有基线,新任务先小流量灰度,观察异常率再放量;全天候不间断执行、失败后无限重试,是容易把单点问题放大成组问题的做法,节律不是演给谁看,而是让系统行为稳定、可解释、可回滚。
五、账号权限与任务隔离:把风险关在单个容器里
账号层有效的动作是分组、小权限和任务隔离,别让一个异常任务拖垮整组账号,群控系统越大,越要用容器化思路管风险。
账号按业务、地域、生命周期分组,权限给到小;任务走白名单,失败触发熔断;新账号设观察期,异常账号及时隔离;操作尽量双人复核,避免一个人一把梭,账号来源要合规,跨组复用要谨慎,说白了,风控管理不是让每个账号都“完美”,而是让一个账号出问题时,别把整批设备一起带下水。
六、数据留痕与异常告警:没有日志的手机群控系统等于裸奔
数据层的判断很简单:设备日志、网络日志、任务日志、告警记录必须留,而且要能关联到具体设备和任务,没有留痕,出了问题只能靠猜,也谈不上风控管理。
日志字段要够用:设备编号、任务ID、出口IP、开始结束时间、结果状态、失败原因、操作人,日志要脱敏、设保留周期,定期抽查,不要只存不查,告警要分级:设备异常、出口异常、任务失败率、账号异常分别到什么阈值通知谁,值班怎么响应,都要提前定,告警到人、闭环到记录,才算真正有用。
七、复盘与降级机制:风控规避的后一道闸是“能停能退”
后一层不是加更多技巧,而是建立指标基线、异常分级和降级预案,做到能暂停、能回滚、能下线,风控管理不是追求零异常,而是异常来了不扩散。
先定基线:任务成功率、失败率、平均时长、出口异常率、设备离线率,异常分级后对应动作要明确:暂停任务、隔离设备、切换合规备用出口、回滚版本、下线账号组,每次异常复盘根因、责任和改进项,定期做降级演练,手机群控系统风控规避说到底不是比谁更会藏,而是比谁的系统更可控、更可解释、更能及时止损。